涡轮公版4/8卡RTX 5090/4090服务器工作站 AI推理与训练的终极解决方案
前言
在当今人工智能技术飞速发展的时代,对大算力的需求与日俱增。无论是深度学习的模型训练,还是大规模推理部署,传统的消费级单卡甚至双卡配置已经难以满足日益复杂的AI工作负载。为此,搭载RTX 5090或RTX 4090涡轮公版的多卡服务器和工作站应运而生,成为科研机构、AI初创公司和大型企业部署AI基础设施的热门选择。
为什么选择涡轮公版?
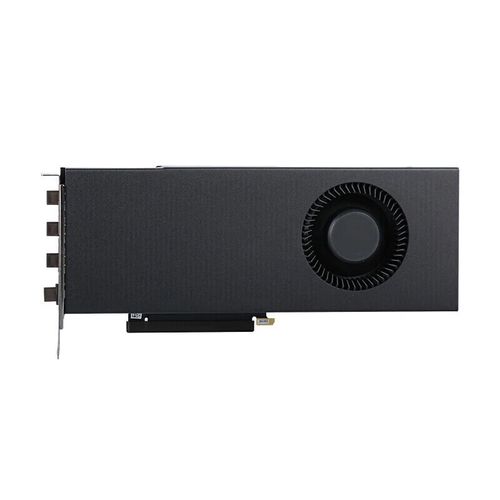
与常见的开放式散热风扇显卡不同,涡轮公版显卡采用封闭式涡轮散热设计,热量从显卡尾部的散热口集中排出。这种设计在多卡并排部署时具有天然优势:它能有效避免热空气在机箱内部循环堆积,让每张显卡都能获得稳定的冷空气,从而维持长时间高负载运行下的性能稳定。对于需要4卡或8卡密集部署的工作站而言,涡轮公版几乎是必然选择。涡轮公版通常符合更严格的工业标准和尺寸规范,便于在机架式服务器中密集安装。
RTX 4090:成熟可靠的现役旗舰
RTX 4090基于Ada Lovelace架构,拥有16384个CUDA核心,配备24GB GDDR6X显存,显存位宽384-bit,带宽高达约1TB/s。凭借其强大的FP16和FP8张量核心性能,单卡即可提供出色的AI训练和周模型推理能力。在多卡互联方面,4090支持PCIe 4.0/5.0总线,在服务器主板上可实现大带宽互联,配合定制的多卡拓扑驱动方案,多卡并行效率可显著提升。通过NVLink?实际消费级40系并不支持NVLink,3000系才支持桥接互联,多卡通信主要依赖PCIe对于大模型训练中的梯度同步可以接受这在多卡8卡集群中,张量并行和流水线分布式训练仍然可以高效运作,同时存储从PCIe结构还可以灵活搭配高带宽CSD例如使用PCIe条多个高ExpressNV模型Storage固态模型轻松达到RAID配置避免Read-load i
模型效率。。本地推理可以使用GPT模型的流水线--效率可以达到理想
……
如若转载,请注明出处:http://www.wkmyy.com/product/48.html
更新时间:2026-10-04 08:27:18